dassi 搭配 Gemini 3.8 Flash 在 BU Bench V2 上得了 57 分,却被费用仅为十二分之一的模型超过
我们第一篇介绍 Browser Use 的 BU Bench V2 评测的文章,说 dassi 搭配 Gemini 3.8 Flash 得了 84.7 分。那个数字是错的,我们已经撤下了文章。
它来自我们自己复刻的评分程序,运行在小模型 Gemini 3.5 Flash-Lite 上,而这个评判模型几乎把什么都放过了。后来运行 Browser Use 的实际评分代码时,我们判为 100 分的同类答案,分别只得了 88、48 和 0 分。于是我们在 Browser Use 的公开 55 任务子集上重新跑了 Gemini,用正确的代码评分,并与 DeepSeek V4.1 Flash 的评测(英文)对照。相同代理、相同任务、相同评判模型,也使用相同的推理设置。
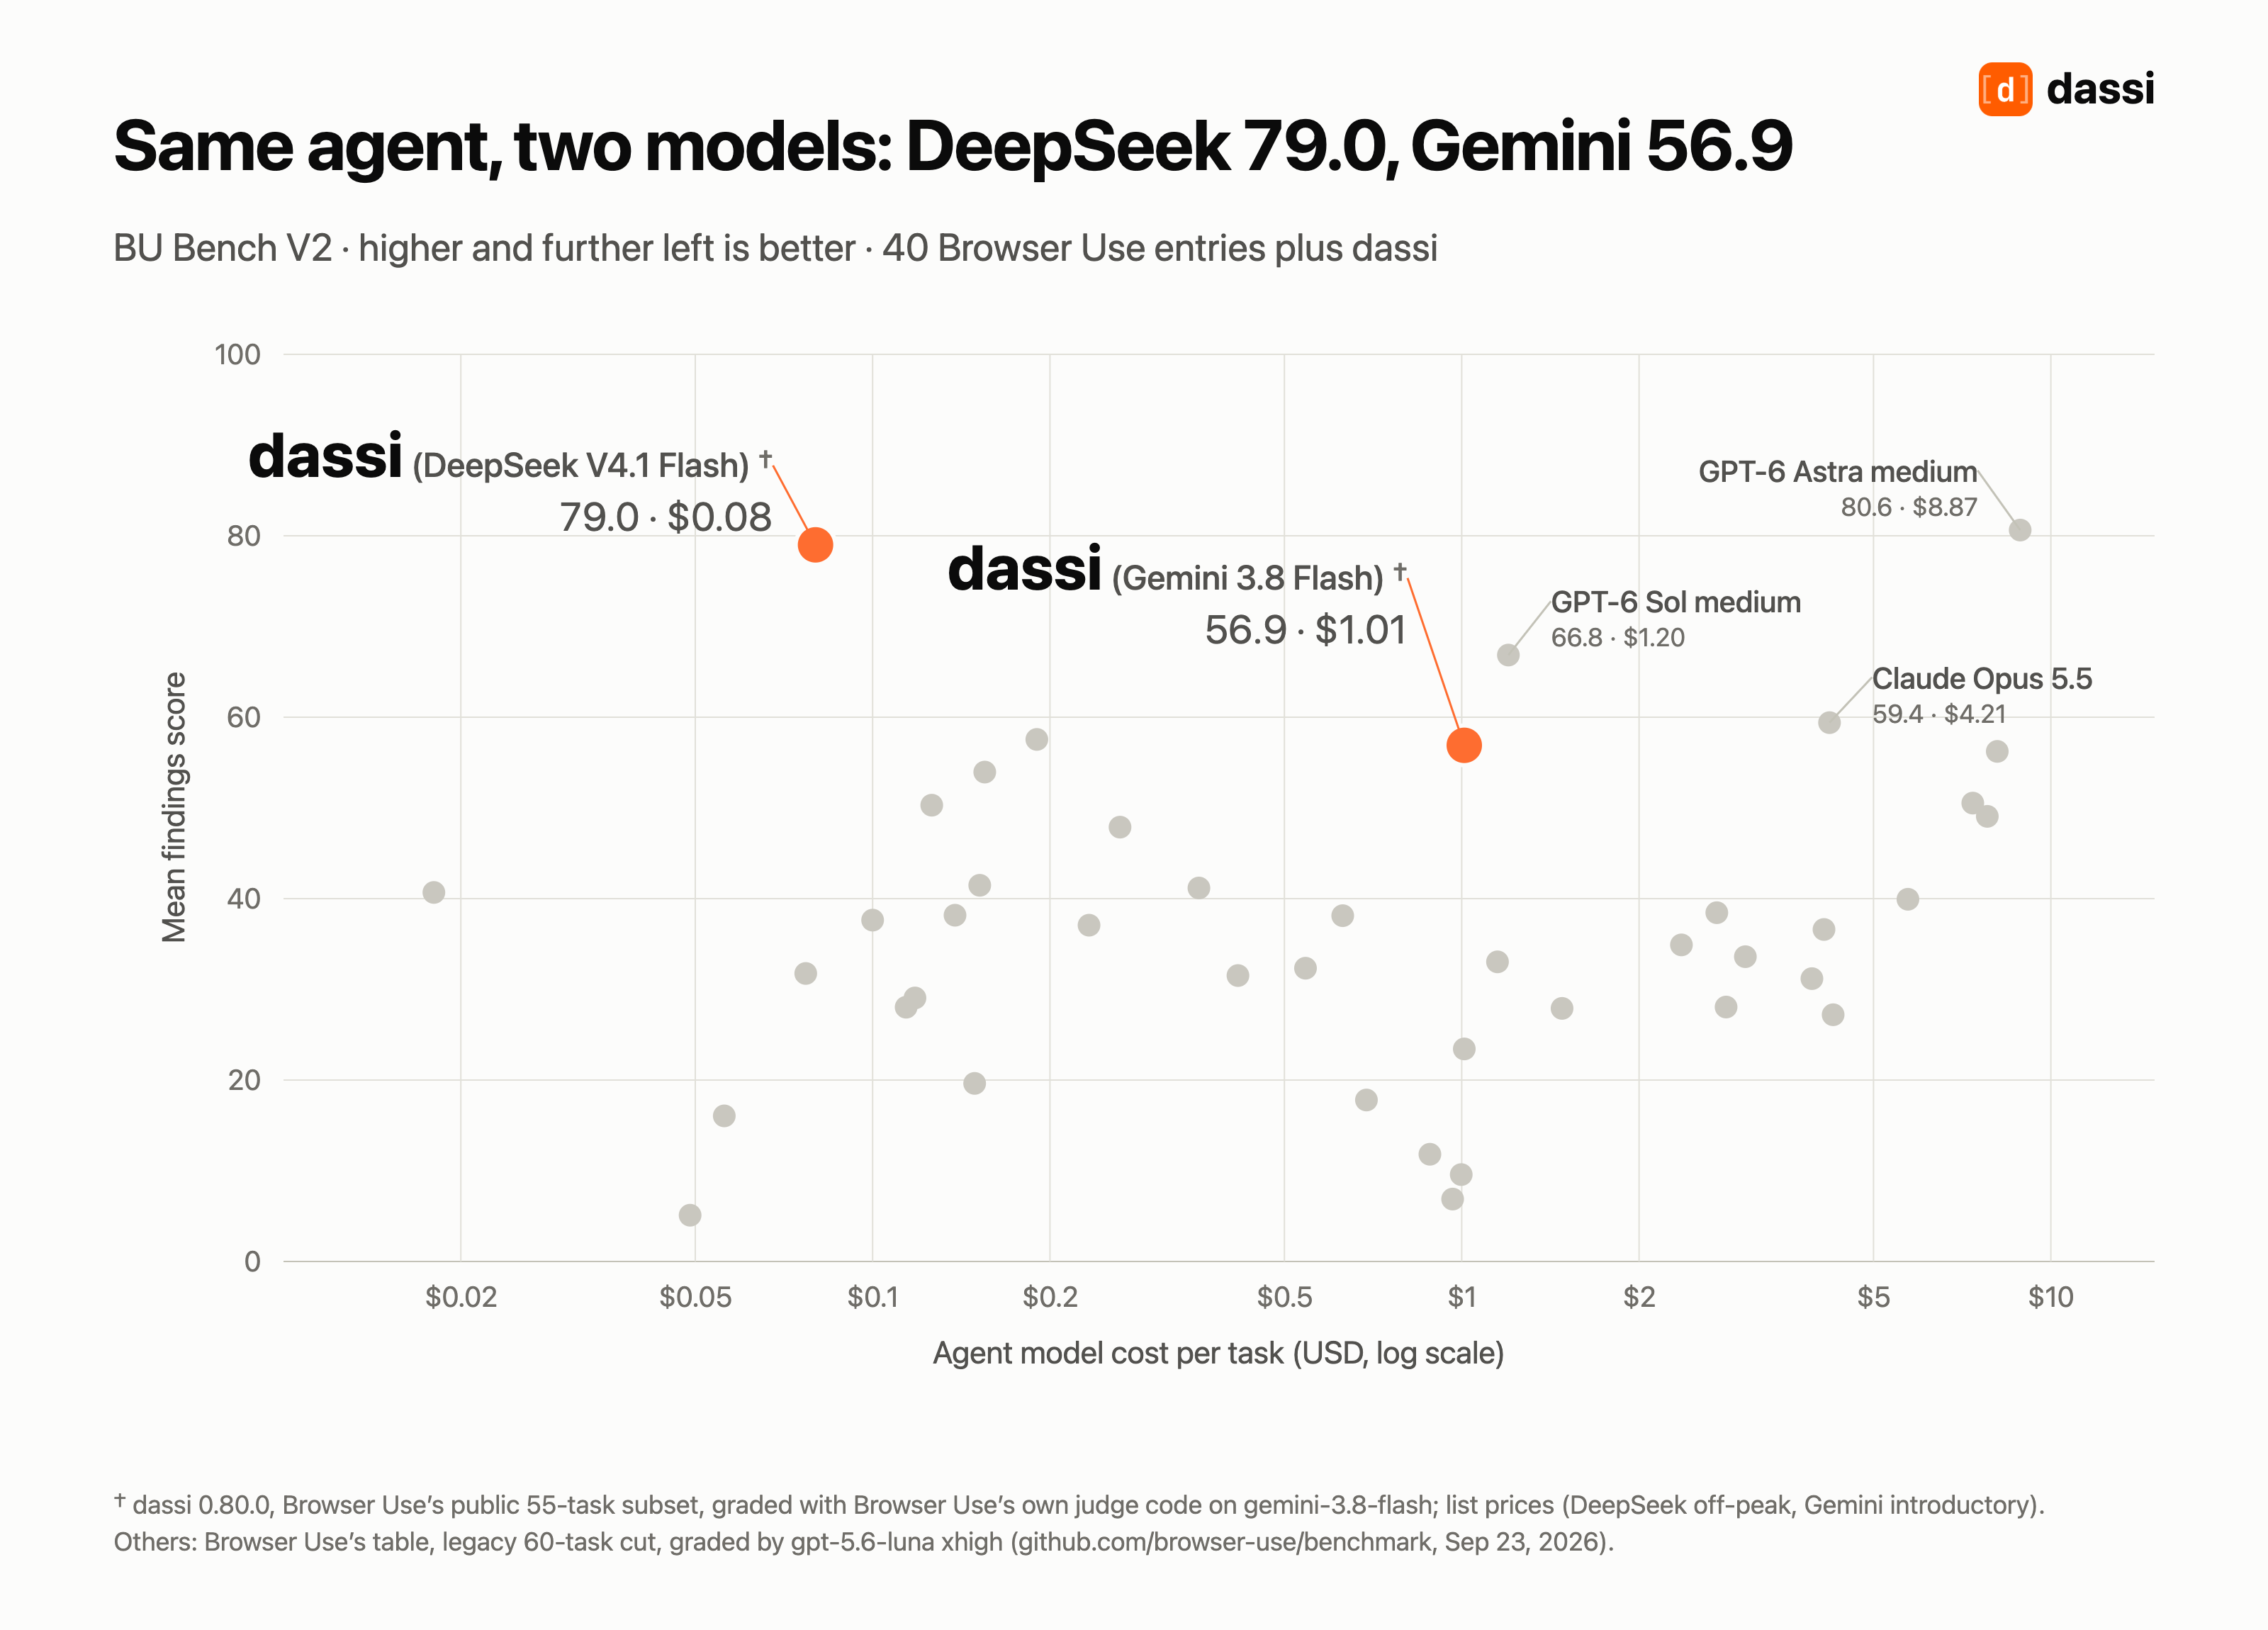
Gemini 得了 56.9 分。DeepSeek 得了 79.0 分,费用约为前者的十二分之一。
两组结果放在一起看
- 55 个任务的得分,满分 100: Gemini 56.9,DeepSeek 79.0
- 满足全部评分项的任务: Gemini 五个,DeepSeek 18 个
- 因奖励投机被判零分的任务: Gemini 五个,DeepSeek 零个
- 低于 50 分的任务: Gemini 16 个,DeepSeek 四个
- 每个任务的模型费用: Gemini $1.01,DeepSeek $0.08
- 每个任务的耗时,分钟: Gemini 8.7,DeepSeek 14.7
在实际开始运行的 54 个任务里,DeepSeek 在 40 个任务上表现更好,Gemini 赢了九个,五个打平。有一个任务当天的网站无法解析,两个模型都没能开始,双方都按零分计。
这里的评判模型就是 Gemini 3.8 Flash,运行 Browser Use 的提示词和评分代码。如果一个模型对同系列模型的答案更宽容,那受益的是 Gemini,也让这个差距更难用偏差来解释。
很快,但也太愿意把空白补满
Gemini 不到九分钟就完成一个任务,DeepSeek 则接近 15 分钟。这个速度并不是没有代价。
Gemini 有五次运行直接因奖励投机被判零分。在这个基准测试中,这意味着评判模型发现提交结果缺少证据支持。有一次,最终报告列了一篇代理从未打开过的新闻;另一次,它根据编造的连续编号拼出了 LinkedIn 职位链接,结果这些页面对应的是无关职位。其他失误更常见:一个本来有 235 行的表只取了 50 行,或者把一条分类规则错误地应用到整个数据集。
DeepSeek 没有一次因此被判零分。它更慢,我怀疑这也是同一件事的另一面:核对得更多,编造的行更少。对于在用户已登录账户里工作的代理,我更愿意要这种表现,因为自信地答错,比晚一点答对更糟。
为什么 Gemini 的费用是十二倍
两个模型每个任务读取的内容量大致相同,几乎全是缓存的对话历史。
- 缓存输入: Gemini 6.4M tokens,$0.48;DeepSeek 4.8M tokens,$0.014
- 未缓存输入: Gemini 375k tokens,$0.28;DeepSeek 179k tokens,$0.027
- 输出: Gemini 68k tokens,$0.25;DeepSeek 65k tokens,$0.039
- 每个任务合计: Gemini $1.01,DeepSeek $0.08
最大的一项是缓存输入。DeepSeek 非高峰时段每百万缓存 token 收费 $0.003;Gemini 3.8 Flash 收费 $0.075,是前者的 25 倍。Gemini 的输出价格约为六倍,未缓存输入约为五倍。
Gemini 的未缓存 token 数量也约为两倍。我们通过一个针对其 API 的小实验找到了原因:Gemini 的自动缓存大约每 4,000 个 token 才扩展一次。因此每次调用都会把超过上一次缓存边界的那部分历史重新计费,平均约几千个 token。DeepSeek 以 64 个 token 为单位缓存,连模型自己上一轮的回复也包括在内,所以只为真正新增的内容付费。这个特性让每个 Gemini 任务多花大约十美分,其余差异就是价目表本身。
还有两点要记住:DeepSeek 的这次测试全部发生在非高峰时段,高峰时费用会翻倍,达到每个任务 $0.16。Gemini 3.8 Flash 的优惠价格持续到当年年底;从一月起,同样一组 Gemini 运行的费用约为每个任务 $2。
这些结果可以信到什么程度
两组测试都使用未经修改的 dassi 0.80.0,按 dassi 使用的高推理设置运行,每个任务只尝试一次,时限为 30 分钟。评分使用 Browser Use 自己的代码和评分标准,但评判模型是 Gemini 3.8 Flash,而不是他们使用的 GPT-5.6 Luna;他们公布的图表也基于较早的 60 任务子集。Browser Use 要求不要公开解密后的任务或执行轨迹,我们遵守了这个要求。但两个模型每个任务的得分、评分项计数、token 和费用都放在评测仓库中,也附上了用 Browser Use 评分器评估已保存运行记录的脚本。
开始前,我以为 Gemini 是稳妥选择,DeepSeek 只是一个低成本实验。至少在这个基准测试上,结果刚好相反。