用官方评分器评测:dassi 搭配 Flash 模型在 Odysseys 上取得 85%
卡内基梅隆大学在四月发布 Odysseys 时,我反复看的数字是 44.5%。那是 Claude Opus 4.6 作为计算机操作代理,在 100 步预算内的成绩:200 个真实用户在自己的浏览器里做过的网页任务,它完整完成了不到一半。(Lawrence Jang、Jing Yu Koh、Daniel Fried 和 Ruslan Salakhutdinov 根据真实 Chrome 浏览历史重建了这些任务,这也是我觉得它比多数基准测试更有意思的原因。)
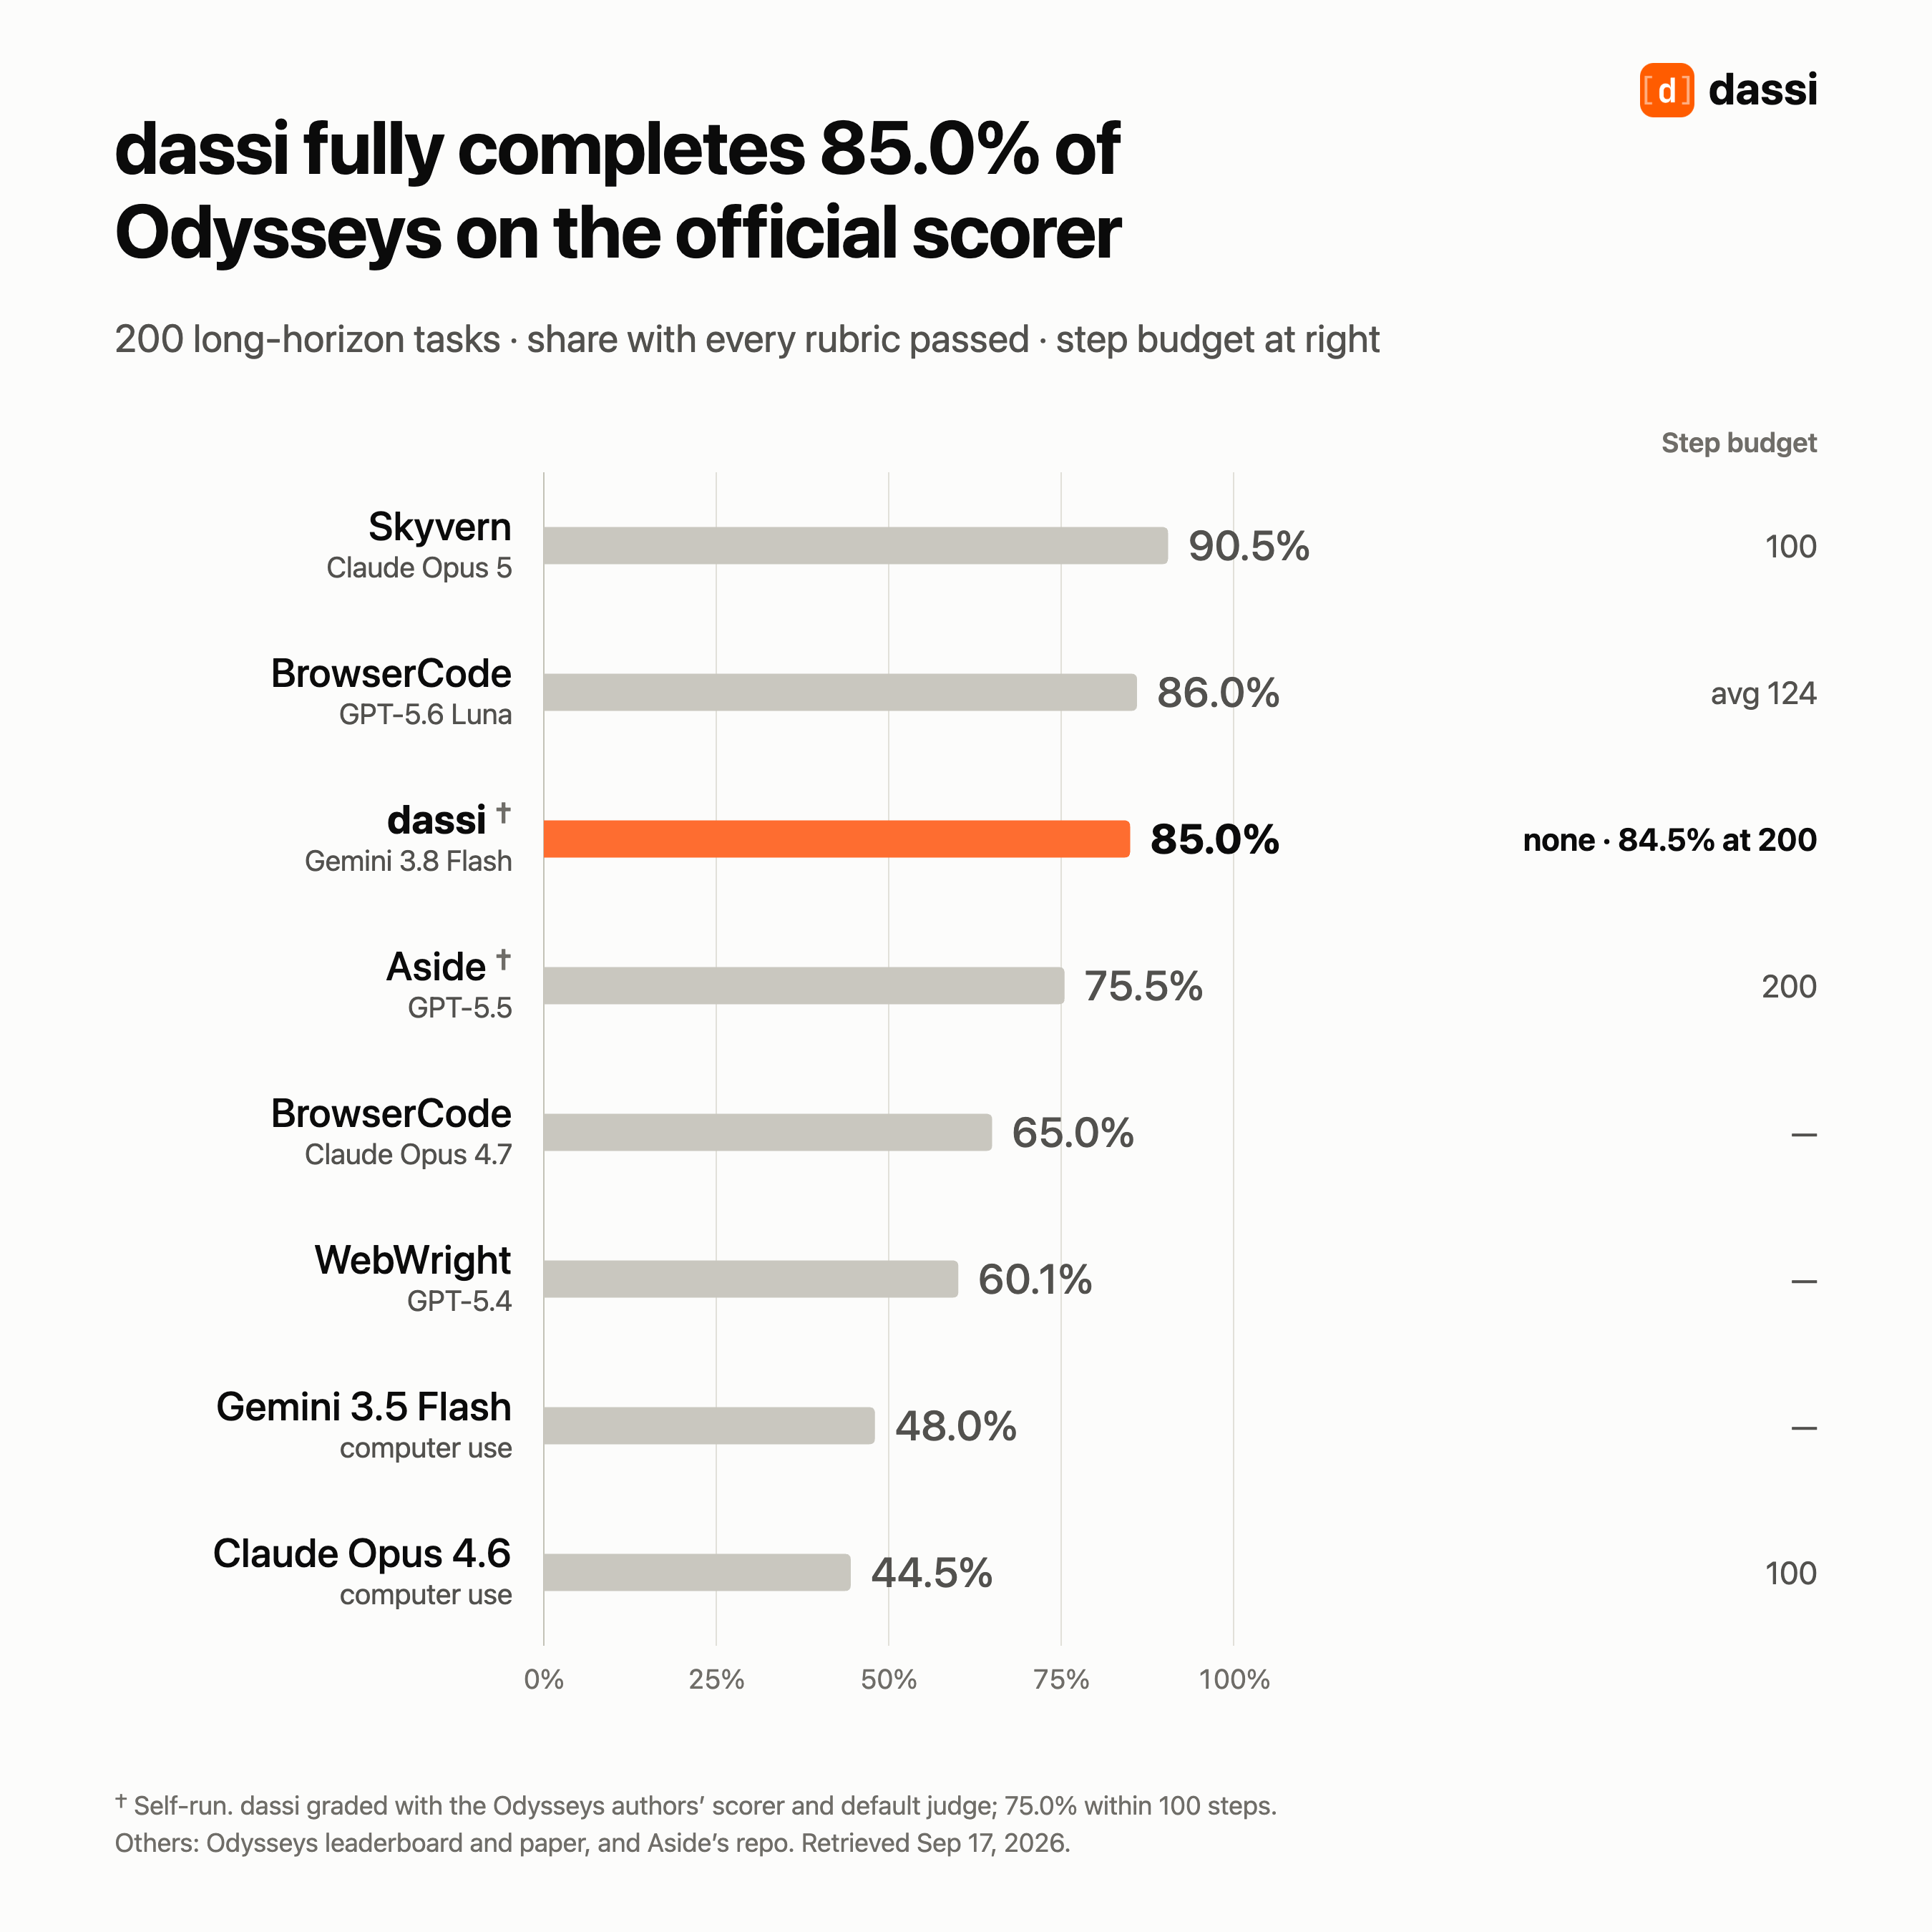
我们用 dassi 的默认模型 Gemini 3.8 Flash 跑完全部 200 个任务,再用作者自己的评分代码和评判模型评分。完整完成了 170 个,即 85.0%。
我们最初公布的是 91.5%。那个数字来自我们自己的评判模型,评分过于宽松,因此我们撤下了原来的文章,并用官方代码对所有结果重新评分。下面是更正后的完整情况。
“完整完成”是什么意思
每个 Odysseys 任务有 3 到 12 条评分标准,整套共 1,225 条,要求像是一个很挑剔的客户写的:确认 Kohl’s 的两件礼物今天能在店里自提,报告 Etsy 商品的店铺名称和可选定制方式,等等。只有全部评分项通过,任务才算完成。一个长任务的九个检查点里做对八个,整体完成率里也不会给你算成功。
所以,85.0% 代表 170 个没有遗漏任何评分项的任务。按单项统计,dassi 通过了 1,225 条中的 1,142 条,约为 93%。
为什么我们的评判模型给了 91.5%,官方却给 85%
作者的评分器在三个具体方面更严格。我逐条检查了那些被我们的评判模型判为完美完成、却被官方扣分的评分项:14 个任务里,一共有 17 条。
- 网站拦截算失败。 17 条中的七条,是网站拦住了代理:Skyscanner 的验证码、The Kitchn 的 PerimeterX 检查、U-Pack 报价表单上的 reCAPTCHA,以及 Theory 的 Access Denied 页面。代理都尝试过,明确说明无法通过,然后从其他地方找到了信息。我们的评判模型为此给了分,官方规则则明确规定:被拦住,该项就失败。
- 评分依据执行轨迹中的证据,而不是代理自己的结论。 另外七条是代理认定某样东西不存在,例如“Hertz 在巴塞罗那没有 Honda”,或者返回的字段少于要求。官方评判模型要求这些结论有代理实际访问过的页面作为依据。
- 最终状态必须能看见。 最后三条是“把最合适的四个商品页面保留在标签页里”这样的要求。我们的评判模型接受了代理的口头说明,官方则要求记录中确实可见。
还有第四点,我想说明,而不是拿来争辩。我们的任务在 CI 服务器上的无头 Chrome 中运行,经过同一个住宅代理。这种环境容易触发真实用户已登录的 Chrome 不常遇到的机器人检查。有几次拦截,例如某个网站根本无法通过代理连接,看起来更像环境问题。我无法证明它解释了多少差距,而排行榜上的每个代理都按同一条规则评分,所以我们采用官方成绩。
与其他代理相比
排行榜上的参赛者并不都使用相同的步骤预算,因此下面列出 dassi 在不同预算下的成绩。
- 不限步骤: 85.0%。使用 GPT-5.6 Luna 的 BrowserCode 平均每个任务用 124 步,成绩为 86.0%。
- 200 步: 84.5%。使用 GPT-5.5 的 Aside 在相同预算下公布的是 75.5%。
- 100 步: 75.0%。使用 Claude Opus 5 的 Skyvern 在这个预算下公布的是 90.5%,明显领先。
这个预算对比对谁都不算讨巧,包括我们。dassi 的一步是一次模型调用,一次调用可以运行一个小程序,完成整个页面上的一串点击。因此,100 步 dassi 与 100 次“截图后点击”并不完全是同一个计量单位。不过,Skyvern 平均用了 65 步就取得了更高成绩,我不想用解释把这一点抹掉。
最难的任务
作者按难度划分了任务,其中 109 个属于“困难”:流程最长,需要跨越最多网站。
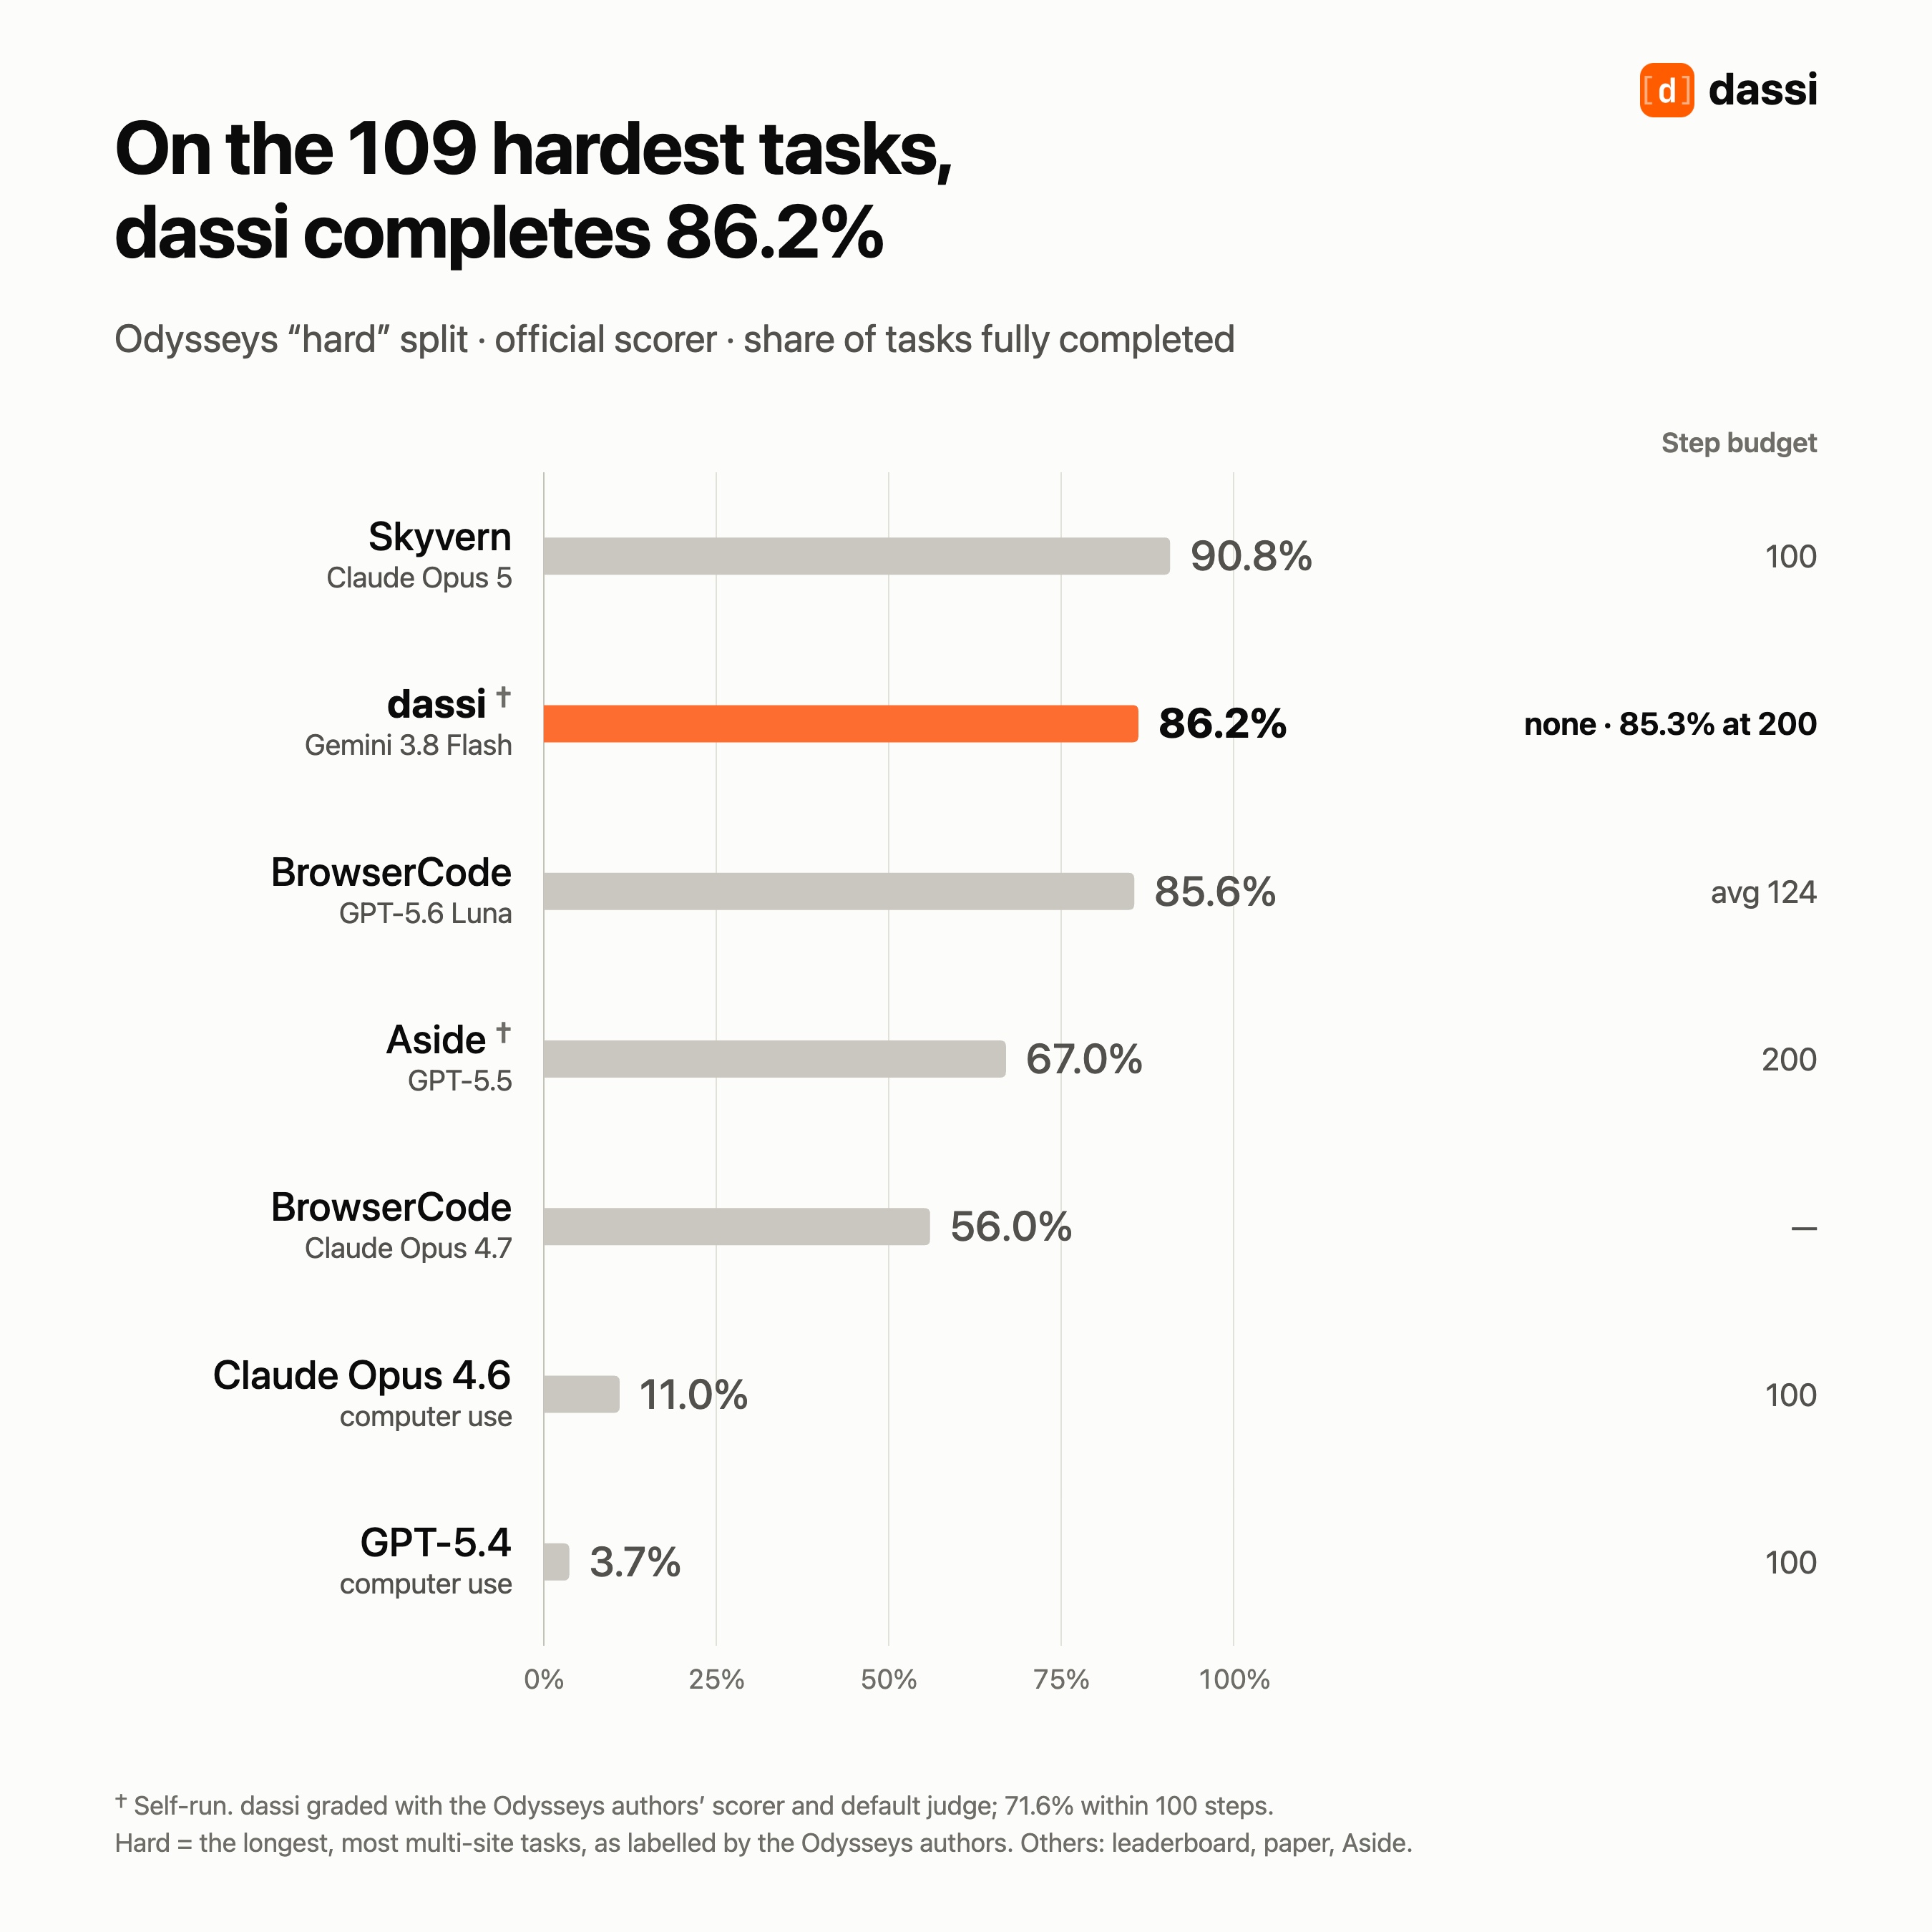
dassi 完整完成了 109 个困难任务中的 94 个,即 86.2%,略高于整体完成率。论文里的计算机操作模型则相反:Claude Opus 4.6 从整体的 44.5% 降到了困难任务的 11.0%,GPT-5.4 降到 3.7%。当任务需要跨四家零售商对比商品,并把正确的页面保留打开时,连续几十次根据截图猜测点击位置,容易积累小错误,直到某一次让整个任务失败。dassi 读取页面结构,包括元素、标签和状态,而不是只看像素。我认为,这很大程度上解释了它在长任务中的表现。
如何核对我们的结果
测试使用的是当时正式发布的 dassi 0.74.1 和默认模型,每个任务尝试一次,没有网站登录,也没有针对某个网站专门调优。每个任务的模型调用费用中位数约为 $0.66,耗时中位数约为六分钟。每个任务的答案、完整会话、我们原来的判定和官方评分结果,都在评测仓库中。把运行记录交给官方评分器的脚本也在那里,任何人都可以重新评分。
被官方评分器扣分,有点让人清醒。但这才是值得引用的成绩。那 30 个没完成的任务也是一份很好的待办清单,可以先从被验证码挡住的任务开始。