Qwen3.8 27B 在 Browser Use 框架中得 17.8 分,在 dassi 中得 49.7 分:BU Bench V2 评测
我们让 dassi 搭配开放权重模型 Qwen3.8 27B,跑了两个基准测试:Browser Use 的 BU Bench V2 和 Odysseys。它能用,比 Gemini 便宜,但速度慢。
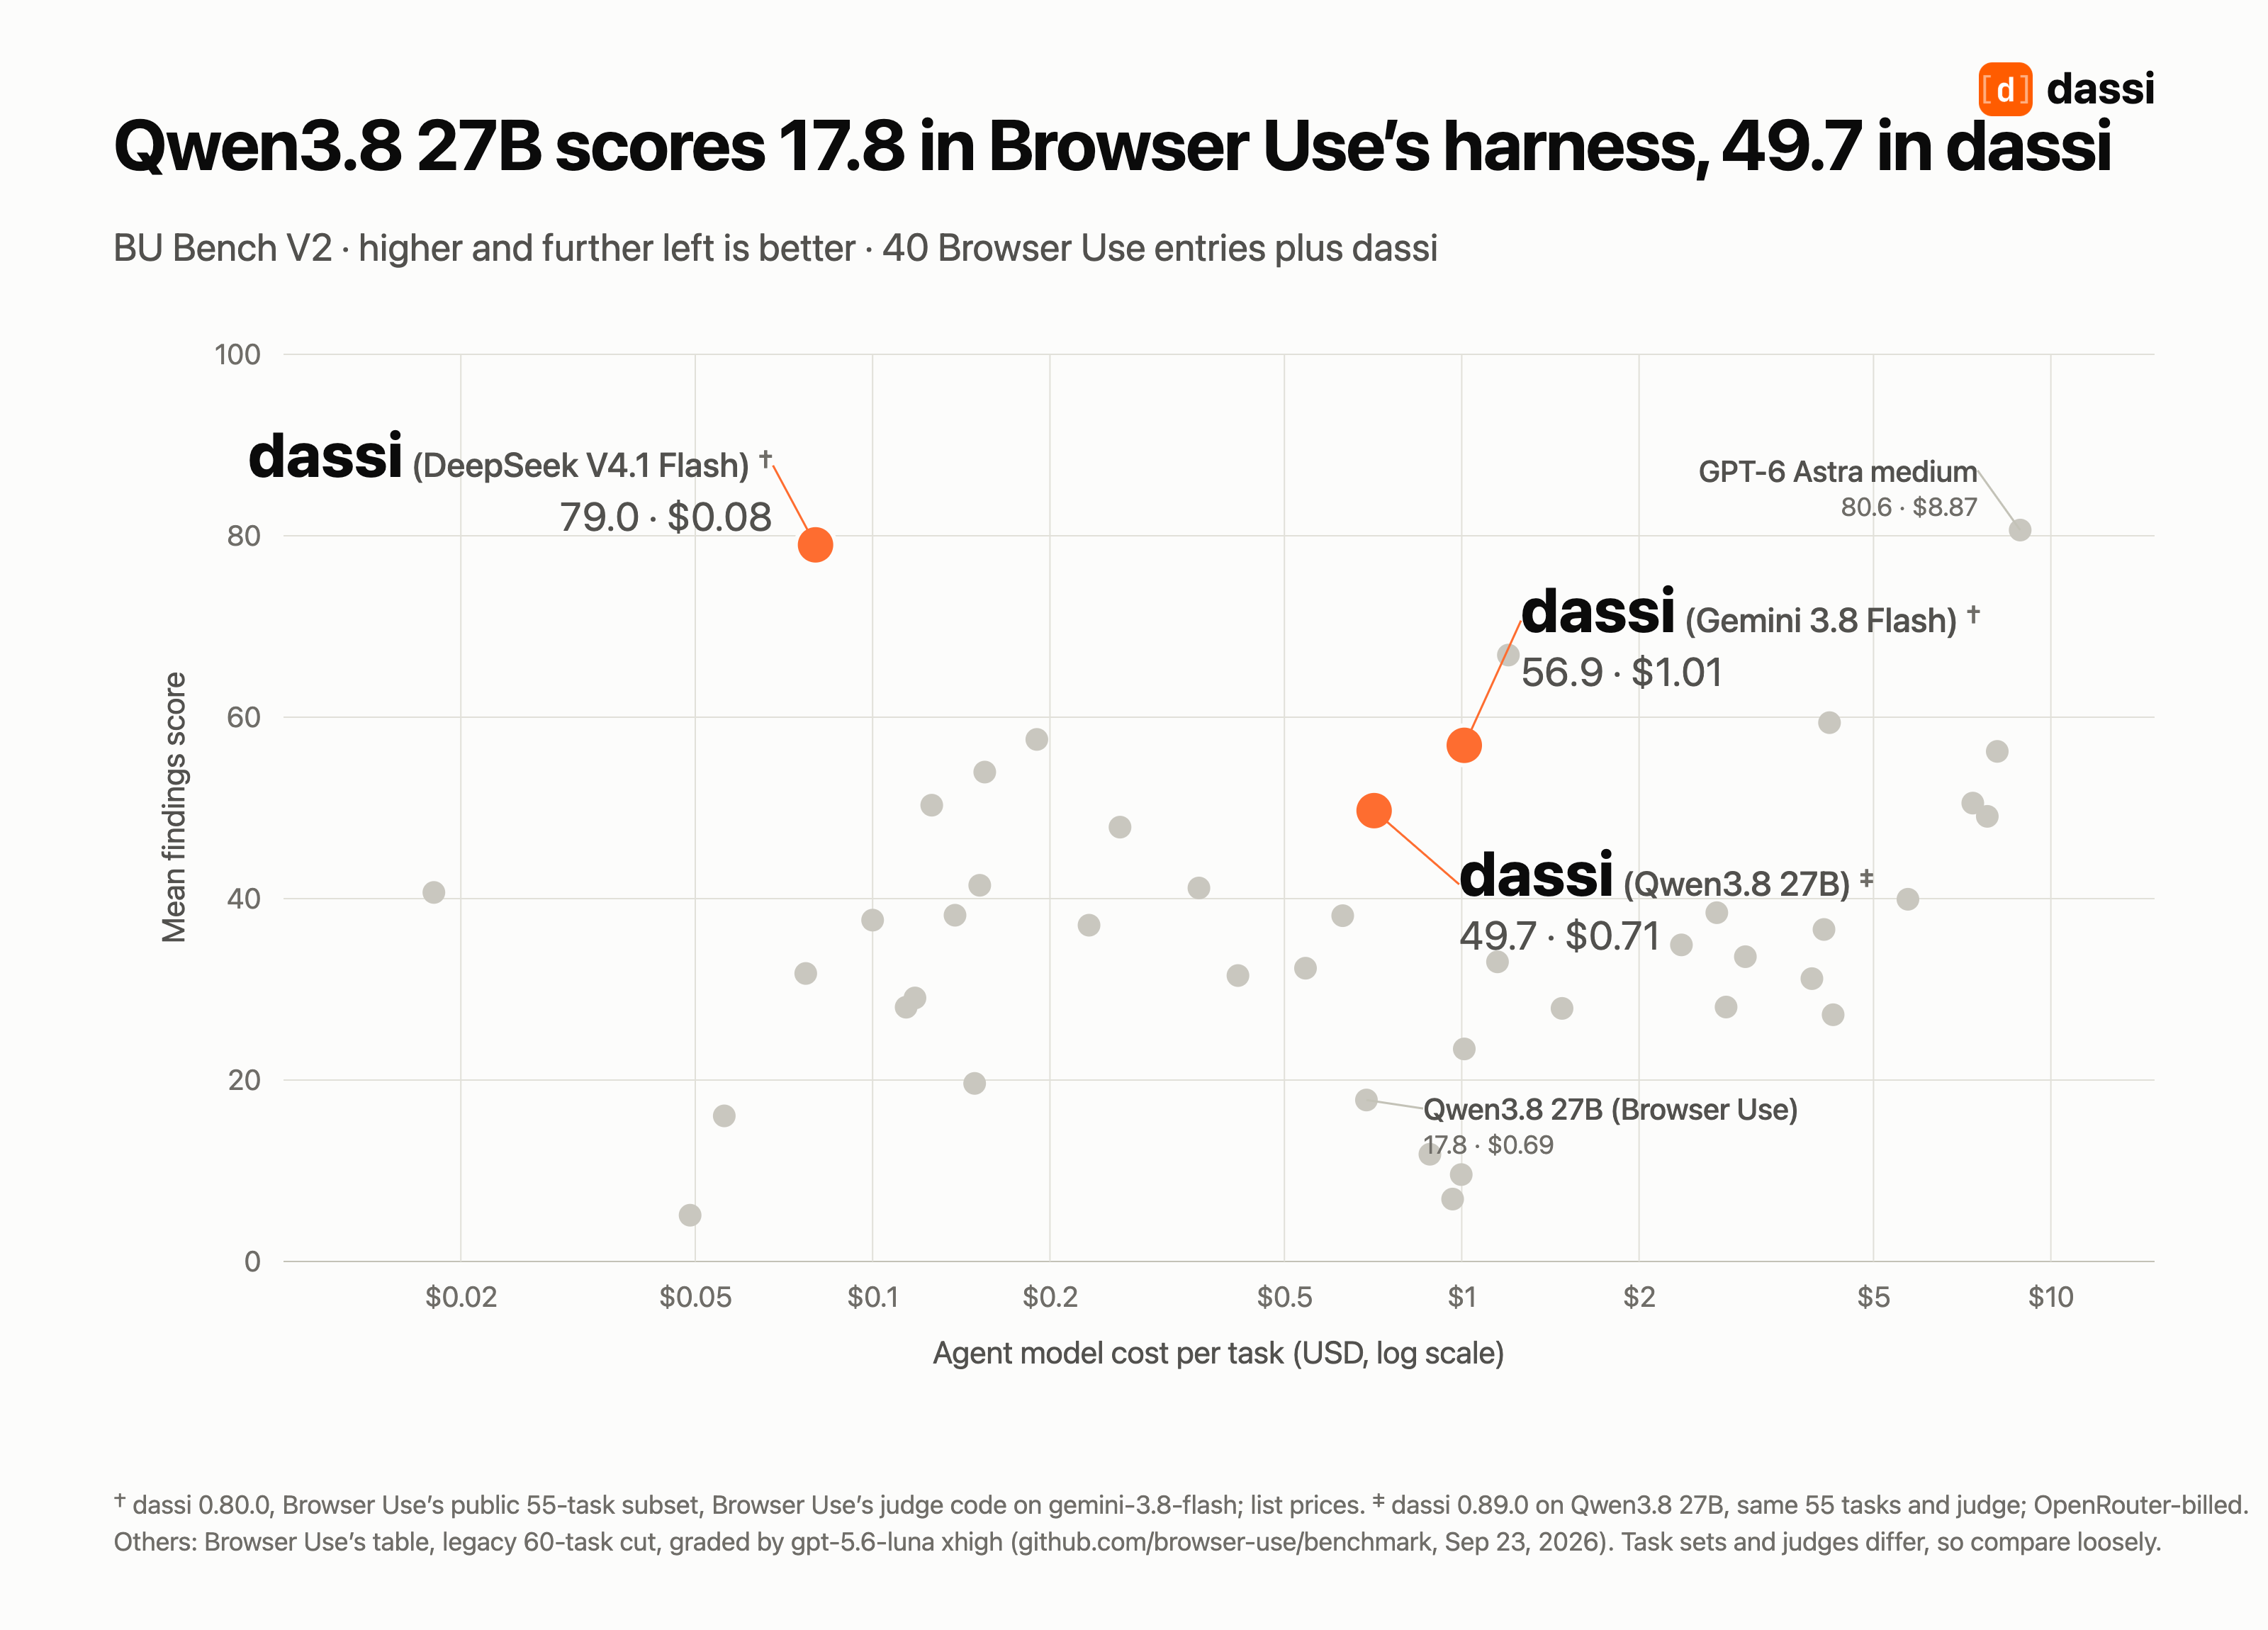
BU Bench V2:49.7 分
在 Browser Use 公开的 55 任务子集上,dassi 搭配 Qwen3.8 27B 得了 49.7 分,十个任务满足全部评分项。它与我们的 DeepSeek 和 Gemini 评测使用相同任务、相同评判模型和相同推理设置:
- DeepSeek V4.1 Flash: 79.0 分,每个任务 $0.08,14.7 分钟
- Gemini 3.8 Flash: 56.9 分,每个任务 $1.01,8.7 分钟
- Qwen3.8 27B: 49.7 分,每个任务 $0.71,43.9 分钟
Browser Use 自己的表格中,这个模型是 17.8 分、每个任务 $0.69。我不会把它当作直接对比:他们使用不同的运行框架、较早的 60 任务子集,以及不同的评判模型。但差距足够大,值得说明我们认为它反映了什么:对于中等规模模型,围绕它运行的代理系统很重要。
Odysseys:40 个任务完成 27 个
从 Odysseys 每五个任务中抽取一个,得到 40 个任务的样本,完整完成了 27 个(67.5%),平均评分项得分为 74.4%。按难度划分,简单任务完成九个中的七个,中等任务完成十个中的八个,困难任务完成 21 个中的 12 个。评分使用 Odysseys 作者自己的评分器,没有修改。
这是 40 个任务的样本,结果可能上下波动约八个百分点,也不能直接与我们公布的 Gemini 3.8 Flash 在完整 200 个任务上的 85.0% 相比。它说明 Qwen 在这里有竞争力,而不是胜过了 Gemini。
问题在于:它很慢
Qwen 在 BU Bench V2 上每个任务耗时约 44 分钟,模型调用次数的中位数为 83 次。Gemini 不到九分钟。我们通常设置 30 分钟时限,但预跑时多数任务都触发了时限,所以这次提高到 60 分钟。即便如此,55 个 BU Bench 任务中仍有 22 个触发时限,评分依据代理截至当时完成的工作。另有八个任务因错误终止。
部分原因在模型:它在便宜的托管服务上生成速度较慢。OpenRouter 上最便宜的服务商每秒生成 15 到 45 个 token,因此我们把路由固定到其中两家速度最快的低价服务商,约为每秒 90 到 160 个 token。还有一部分可能来自我们自己的测试环境,下文会说明。无论如何,49.7 分可能低估了更快环境下的表现,但我无法量化差多少。
费用
在 OpenRouter 上,费用约为每个任务 $0.71,测量来自最后运行的 15 个任务;这批运行没有失败任务。它接近 Browser Use 对相同模型公布的 $0.69,也约为 DeepSeek V4.1 Flash 在同一基准测试中费用的九倍。
整个评测覆盖两个基准测试,总费用为 $110.55。其中相当一部分,我估计约四分之一,没有换来有效结果,原因如下。
哪些地方出了问题
我们原计划在 36 小时内完成,但没有做到。四个 CI 分片因内存不足被内核终止,每个分片内已完成的任务结果也一起丢了,因为被终止的运行无法上传任何结果。
我们查看宿主机的内核日志,找到了原因。每个 CI 容器的内存上限为 4 GiB,而 Chrome 把它用满了:29 到 89 个 Chrome 进程占了约 4 GB,dassi 扩展本身不到 600 MB。随后,我们在本地用一个较重的 Odysseys 任务复现了问题。一个广告很多的新闻页面创建了约 700 个 iframe,多数是广告和 Cookie 同步框架,Chrome 又把运行中的 iframe 分配到大约 120 个渲染进程中。我们尝试限制代理可以打开的标签页数量,但测试中代理从未达到这个上限,因此只能说明标签页不是全部原因;广告框架占了更大一部分。速度慢也可能部分来自内存压力,容器接近内存上限时反复折腾会很慢,但我们还没有证明这一点。
有效的办法是把分片缩小到每批三到四个任务,这样一次终止只会丢掉几个任务,而不是 20 个。六个 BU Bench 任务和九个 Odysseys 任务的第一次运行丢失后,各重跑了一次,最终计入的是重跑结果。
这些结果可以信到什么程度
- 两组测试都使用 dassi 0.89.0,每个任务尝试一次,采用高推理设置和 60 分钟时限,而上面其他模型的测试时限为 30 分钟。这次还把 OpenRouter 路由固定到了两家服务商;这个固定路由设置不包含在任何正式发布的 dassi 版本中。
- BU Bench V2 使用 Browser Use 自己的评分代码,评判模型为 Gemini 3.8 Flash,而非他们使用的 GPT-5.6 Luna。Odysseys 使用作者的评分器及其默认评判模型。评判模型确实存在波动,因此更有意义的是大量任务的平均结果。
- 这些成绩都没有经过两个基准测试维护者的核验。
每个任务的 ID、得分、状态、token 数量和耗时都放在评测仓库中。按 Browser Use 的要求,没有公开任务文本或执行轨迹。